 paper2epub
Del código LaTeX a EPUB con pandoc: qué le pasa a un paper de arXiv
Pregunta cómo pasar un paper de arXiv a un lector electrónico y alguien te dirá: no toques el PDF, arXiv tiene el código LaTeX, convierte eso con pandoc. Suena bien. El código tiene cada ecuación escrita en LaTeX, cada sección y cada referencia, sin nada que adivinar por la posición en la página. Así que lo probé con un paper real y miré qué sale.
La prueba: Direct Preference Optimization (Rafailov et al.), el mismo paper que en la comparación con Calibre. Su código tal como lo sirve arXiv (versión 3), pandoc 3.9 con la orden que recomienda todo el mundo, pandoc main.tex -o dpo.epub, y otra vez con --mathml. Enfrente, paper2epub en esta web, a partir del PDF. Los dos libros, con la misma fuente y el mismo tamaño, en la misma pantalla de seis pulgadas.
Conseguir el código
En la página del paper en arXiv, TeX Source (en Access paper) descarga un archivo comprimido. Dentro van los .tex, los ficheros de estilo del congreso, las figuras y, aquí, un main.bbl. El fichero principal lo tienes que encontrar tú (aquí main.tex, que carga commands.tex), instalar pandoc y ejecutarlo desde esa carpeta. No es difícil, pero es trabajo de terminal, y solo funciona cuando hay código: los papers que se suben como PDF (escritos en Word, por ejemplo) no tienen, y los artículos de revista casi nunca lo traen.
Ecuaciones
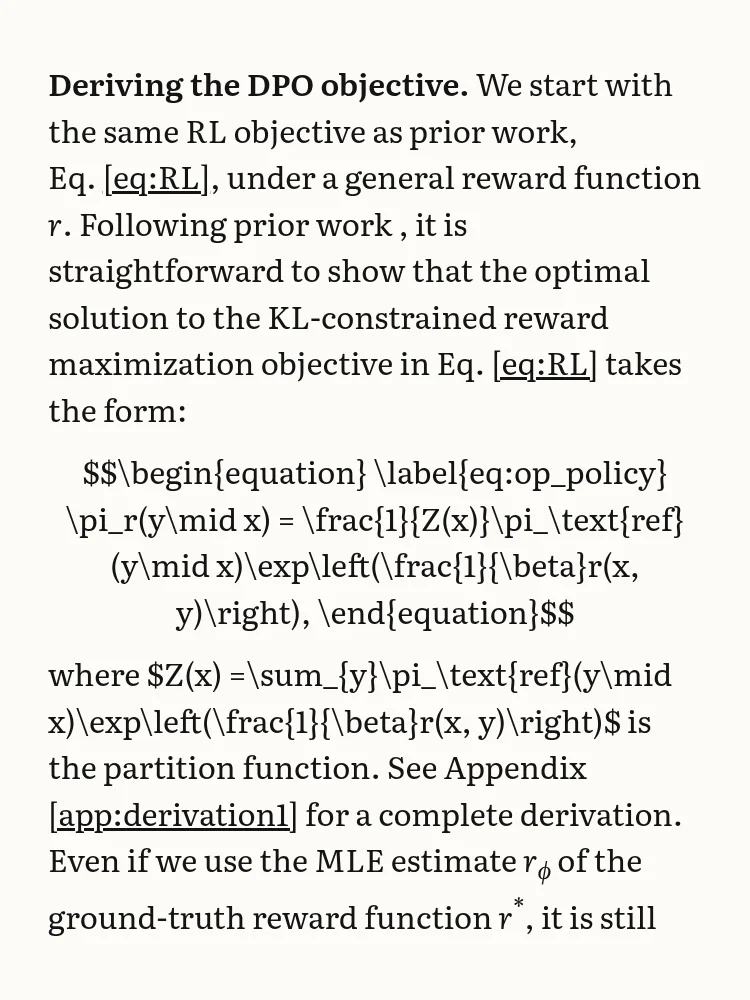
Este es el pasaje que presenta la ecuación principal del paper, en la página 4.
pandoc
paper2epub
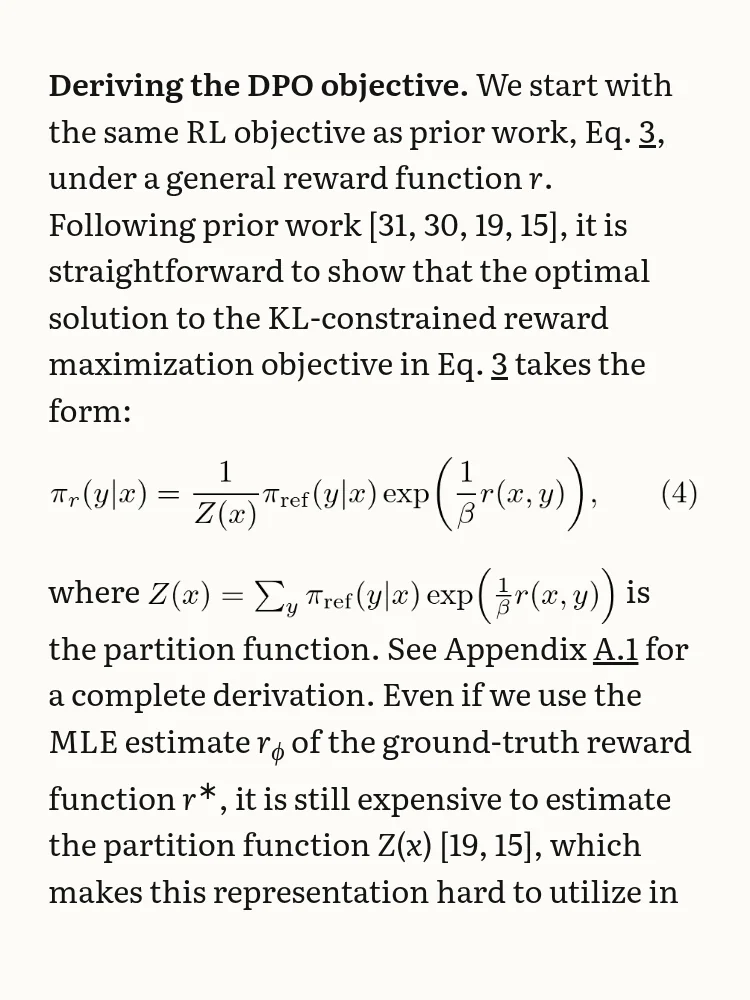
Por defecto, pandoc escribe las matemáticas de un EPUB como texto: letras en cursiva, subíndices y superíndices. Eso vale para rϕ, pero no para una fracción. Lo que no puede escribir así se queda en el LaTeX del que venía, con sus dólares y todo. En este paper son 29 de las 32 ecuaciones destacadas y 14 fórmulas en línea: casi todas las matemáticas.
Con --mathml, pandoc las escribe en MathML, el estándar de las matemáticas en páginas web y libros electrónicos, y solo falla una ecuación. Cómo se ve entonces depende del lector. Amazon dice que su Enhanced Typesetting admite MathML, y Kobo lo da por soportado en sus lectores de tinta, pero en los foros los lectores cuentan resultados irregulares con ecuaciones complejas. No he podido probarlo en un dispositivo, así que no lo enseño. paper2epub no depende de eso: cada fórmula se compone con LaTeX en una imagen, que cualquier lector muestra.
Citas y referencias
El código no trae fichero .bib: como muchos códigos de arXiv, solo lleva el main.bbl que compiló LaTeX, y pandoc no lo lee. Así que las 58 citas del paper desaparecen. Donde el PDF dice «Following prior work [31, 30, 19, 15], it is», el EPUB dice «Following prior work , it is». Y no hay lista de referencias al final.
A las referencias cruzadas les va algo mejor: son enlaces, pero 38 enseñan la etiqueta interna en vez del número. «Eq. [eq:RL]» es la ecuación 3, y «Appendix [app:derivation1]», el A.1. Varias, además, no llevan a ninguna parte: los enlaces que saltan de un capítulo a otro apuntan a anclas que no existen.
Con pandoc, --citeproc y el .bib arreglarían las citas, si tuvieras el .bib. paper2epub las saca del PDF, que ya las trae numeradas: cada una es un enlace a su entrada de la bibliografía (91 enlaces a 51 entradas en este paper).
Figuras
Las figuras de DPO se componen de ocho imágenes, y seis son ficheros PDF: todas las gráficas de resultados. pandoc las mete en el EPUB tal cual. Pero el PDF no es uno de los formatos de imagen con los que puede contar un EPUB (JPEG, PNG, GIF, SVG, WebP), así que las normas piden una alternativa, que pandoc no añade. Las tres figuras con los resultados se quedan sin nada que un lector pueda mostrar. Convertirlas antes a PNG, una a una, lo arreglaría. paper2epub recorta las figuras de la página del PDF, así que una gráfica dibujada como PDF es una más.
El validador
epubcheck es el validador de referencia de los EPUB, el que pasan las librerías antes de aceptar uno. En el libro de pandoc da 40 errores: los 34 enlaces que no llevan a ninguna parte y las 6 imágenes PDF. En el de paper2epub, ninguno.
Cuándo es mejor pandoc
pandoc no es una mala herramienta. Es una herramienta general, y brilla cuando el código es tuyo: tienes el .bib, las figuras en PNG o SVG, y puedes pasarle --citeproc y --mathml y retocar el resto a mano. Las tablas de este paper, por ejemplo, salieron como tablas de verdad, solo con algún «2-3» suelto donde una raya abarcaba dos columnas. Si escribes tus propios papers en LaTeX o Markdown, merece la pena aprenderla.
Para el paper de otra persona, descargado de arXiv para leerlo en el tren, el código LaTeX no es el atajo que parece. Es un archivo que descomprimir, un programa que instalar y un libro en el que hay que arreglar las matemáticas, las citas y las gráficas. El PDF, en cambio, siempre existe y lo trae todo ya maquetado. De ahí parte paper2epub.
Para ver lado a lado las otras formas de leer un paper en un lector, está ¿k2pdfopt, KOReader, Calibre o EPUB?